A personalidade ao redor do mundo
The Big Two in English, Spanish, French, Russian, Turkish, and Persian
Publicado originalmente por Vectors of Mind.
Certo, vamos fazer uma pequena pausa nessa coisa da sapiência. Na verdade, eu tinha toda uma série de análises psicométricas na fila antes de ser atraído pelo chamado do clarim da consciência. É simplesmente muito difícil desviar o olhar.

Comecei este blog para explorar a Hipótese Lexical a partir da perspectiva do aprendizado de máquina. Os modelos de personalidade definem os traços sobre os quais mais se fofoca em uma língua, e podemos mensurar isso muito melhor na era do GPT. Os modelos de personalidade derivados tanto de vetores de palavras quanto de pesquisas tradicionais acabam retornando aos mesmos poucos traços, especialmente aos Dois Grandes: autorregulação social e dinamismo. Para relembrar o assunto, confira Os Cinco Grandes são Vetores de Palavras e O Fator Primário da Personalidade.
Os Cinco Grandes foram encontrados de forma independente em muitas línguas, mas a comparação entre as línguas é sempre qualitativa. Pesquisadores aplicam uma pesquisa de adjetivos de personalidade em turco ou alemão, fazem uma análise fatorial e, de certo modo, observam os fatores para ver se são os mesmos. Esses dados não podem ser usados para dizer que “a Extroversão está deslocada 15 graus em relação à Conscienciosidade em alemão, em comparação com o inglês”. Para sermos tão precisos, ambas as línguas teriam de compartilhar alguma base.
Se você aplica perguntas em várias línguas, pode relacioná-las de duas maneiras: 1) encontrando uma coorte bilíngue capaz de responder em ambas as línguas ou 2) presumindo que as traduções das palavras são equivalentes em uma relação de um para um (por exemplo, fun é perfeitamente equivalente a divertido em espanhol). No primeiro caso, há um forte efeito de seleção. E se as pessoas bilíngues tendessem a ter uma educação melhor? O segundo simplesmente não é verdadeiro. Na verdade, o motivo para fatorar as línguas em conjunto é entender como a estrutura da personalidade pode divergir entre elas. Presumir que as palavras são iguais frustra o propósito.
Minha pesquisa mostrou que é possível extrair a estrutura da personalidade de modelos de linguagem em inglês. Uma pergunta natural é como isso muda quando se acrescentam outras línguas. Com modelos treinados em dezenas de línguas, explorar isso se torna bastante simples. É possível mapear qualquer número de línguas para a mesma base.
Os Dois Grandes, mais uma vez #
Usei XLM-RoBERTa para atribuir similaridade entre adjetivos de personalidade. Estranhamente, esse modelo é resultado do genocídio em Mianmar. A Meta ocupa a posição pouco invejável de ter de remover conteúdo em lugares sobre os quais tem pouquíssima compreensão. Tecnicamente, isso é chamado de problema de aprendizado por transferência. A empresa gostaria de treinar um classificador de discurso de ódio em inglês (ou em outra língua com boas fontes) e então fazê-lo se aplicar a outras línguas. Na era das trevas da modelagem de linguagem (2018), isso funcionava muito mal. A fala coloquial em birmanês para “vamos reunir os gays e matá-los” parecia aos classificadores algo como “deveria haver menos arco-íris”. Isso, é claro, passava despercebido pela moderação de conteúdo. O NYT explicou a consequência: A Genocide Incited on Facebook, With Posts From Myanmar’s Military
A resposta da Meta foi construir um modelo de linguagem capaz de mapear melhor qualquer língua (bem, 100 línguas) para vetores de palavras no mesmo espaço compartilhado. Desse modo, um classificador de discurso de ódio treinado em inglês pode se estender melhor a outras línguas. (É necessário menos birmanês para fazer o fine-tuning.) Usando esse modelo, fiz o embedding de palavras de personalidade em quatro línguas: inglês, espanhol, francês e turco. Abaixo estão os dois primeiros fatores:

Eles servem para separar as diferentes línguas. O primeiro fator distingue o turco das línguas indo-europeias. No segundo fator, as línguas românicas são adjacentes (embora também próximas do turco).
Isso faz sentido. O modelo é treinado para prever a próxima palavra de uma frase, portanto naturalmente incluirá informações específicas de cada língua. Se alguém está falando em espanhol, não costuma mudar para o turco. A esperança é que também haja direções no espaço vetorial que correspondam a informações sobre a personalidade.
Se as línguas forem razoavelmente independentes, são necessárias pelo menos 3 dimensões para separar 4 línguas em seus próprios grupos não sobrepostos. Vejamos os próximos componentes principais.

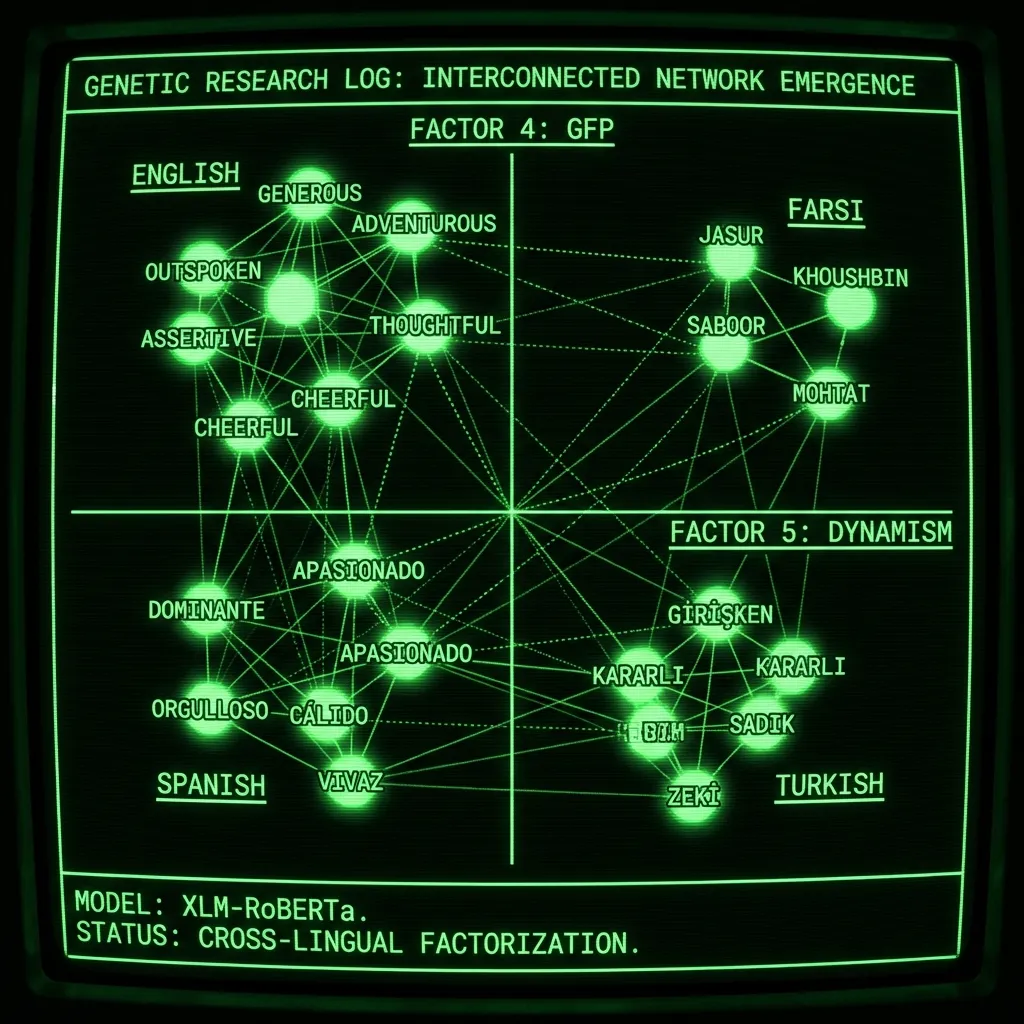
O fator 4 é o primeiro fator que não foi aprendido para separar as línguas, e é o Fator Geral da Personalidade! Em inglês: domineering, ruthless, compulsive e selfish vs generous, gentle e thoughtful. Argumentei que a melhor maneira de compreender esse fator é como a tendência a viver segundo a Regra de Ouro. A Teoria de Eva da Consciência foi, na verdade, resultado de questionar o que isso selecionaria em nossa história evolutiva. O fator 5 também diz respeito à personalidade; colocando-os juntos:

Obtemos os Dois Grandes! O fator cinco (ou o segundo, entre os fatores da personalidade) é o Dinamismo: adventurous, imaginative e enthusiastic vs cautious, reserved e cowardly. É impressionante que isso surja com tanta regularidade. Há 2.500 citações ao artigo sobre os Dois Grandes e, ainda assim, os pesquisadores não percebem que eles são simplesmente os dois primeiros fatores não rotacionados da personalidade geral. A crença comum de que eles existem de algum modo em uma relação hierárquica com os Cinco Grandes decorre do abandono, por parte dos pesquisadores, do tratamento direto da linguagem pouco depois de criarem os inventários dos Cinco Grandes. Desde então, qualquer tentativa de compreender a personalidade básica ou geral precisa ser feita em referência aos Cinco Grandes. Mas as palavras vieram primeiro, e os modelos de linguagem agora facilitam a análise da linguagem nesse nível fundamental.
Precisamos ir mais fundo #
Acrescentar russo e persa produz os mesmos fatores:

Segundo meus padrões de engenheiro preguiçoso, isso exige bastante trabalho, porque requer encontrar um bom prompt para cada língua. Trabalhei com o Google Tradutor e falantes nativos para acertar isso, e é possível ver que a distribuição do persa ainda está deslocada no fator 4. Meu palpite é que meu método de ignorar qualquer fator que não seja compartilhado é tosco demais para tantas línguas. O fator 4 provavelmente é usado como GFP e também para separar o persa (um pouco). Nada mantém esses fatores puros; temos muita sorte de a distribuição ser tão bem-comportada quanto é. Fazer algum pré-processamento (como centralizar em zero cada agrupamento linguístico) talvez resolva isso.
Até onde sei, esta é a primeira vez que várias línguas foram fatoradas em conjunto. Isso seria publicável com resultados apenas em inglês e espanhol, e aqui cheguei a seis, incluindo duas línguas não indo-europeias. Isso também lança luz sobre a natureza dos Dois Grandes, uma das construções mais populares — e incompreendidas — da psicometria.
Limitações #
Eu fiz esta pesquisa da maneira mais tosca possível. Encontrei 100 palavras de personalidade em um guia de inglês como segunda língua e, em seguida, traduzi-as para outros idiomas usando o Google Tradutor. Quando havia duplicatas, eu as removia. Isso não é tão ruim quanto parece. Os dois primeiros fatores permanecem praticamente inalterados em inglês, quer se utilizem 100 ou 500 palavras. Mas, se este fosse um artigo de fato, obviamente seria desejável desenvolver, de forma independente, um conjunto de palavras em cada vocabulário. Há várias outras limitações:
Idiomas insuficientes! Se eu publicasse isto, gostaria de acrescentar uma dúzia de idiomas que não são tipicamente estudados na ciência da personalidade. Na verdade, foi por isso que nunca cheguei a publicá-lo. Isso dá muito trabalho e exigiria falantes nativos de vários idiomas asiáticos.
Modelos multilíngues distorcidos pelos dados de treinamento. Os modelos de linguagem são treinados para prever a próxima palavra de uma frase. Se forem treinados com vários idiomas, tentarão transferir parte desse conhecimento. Contudo, no caso dos idiomas menores, isso poderia parecer mais como se seus significados fossem coercitivamente ajustados a analogias presentes nos idiomas mais bem representados em fontes de dados (inglês, chinês, russo etc.).
As consultas constituem um grau de liberdade do pesquisador. O método que utilizo para fazer o embedding de palavras é “Minha personalidade pode ser descrita como
Modelo de linguagem desatualizado. Fiz este trabalho há mais de 2 anos, muito antes do lançamento do GPT-4. Eram tempos mais simples.
Conclusão #
Se eu ainda estivesse na academia, esta seria minha agenda de pesquisa. Acrescentar o maior número possível de idiomas e tentar compreender todas as formas pelas quais o método pode ser enviesado. No fim, ele talvez produza um modelo universal da personalidade superior aos Cinco Grandes. Isso nos ajudaria a compreender melhor quem somos e talvez até de onde viemos. Pois é a linguagem que define nossa espécie atualmente, e foi a linguagem que forjou nossa psique em um passado remoto. Somos habitualmente sociais porque, milhares de anos atrás, não administrar sua reputação significava morrer. Os modelos de personalidade são mapas da linguagem; são vetores na evolução de nossa mente.

Ler outros artigos