विश्व भर में व्यक्तित्व
The Big Two in English, Spanish, French, Russian, Turkish, and Persian
मूलतः Vectors of Mind में प्रकाशित।
ठीक है, आइए कुछ समय के लिए प्रज्ञता वाली बातों से विराम लेते हैं। चेतना के स्पष्ट आह्वान से आकर्षित होने से पहले मैंने वास्तव में मनोमिति से जुड़ी काफी सामग्री तैयार कर रखी थी। इससे नज़रें हटाना बस बहुत कठिन है।

मैंने यह ब्लॉग मशीन लर्निंग के दृष्टिकोण से शाब्दिक परिकल्पना का अन्वेषण करने के लिए शुरू किया था। व्यक्तित्व मॉडल किसी भाषा में उन गुणों को परिभाषित करते हैं जिनके बारे में सबसे अधिक गपशप की जाती है, और GPT के युग में हम इसे कहीं बेहतर ढंग से माप सकते हैं। शब्द-वेक्टरों या पारंपरिक सर्वेक्षणों से व्युत्पन्न व्यक्तित्व मॉडल उन्हीं कुछ गुणों पर लौटते हैं—विशेष रूप से बिग टू (Big Two) पर: सामाजिक आत्म-नियमन और गतिशीलता। इसके पुनरावलोकन के लिए The Big Five are Word Vectors और The Primary Factor of Personality देखें।
बिग फ़ाइव (Big Five) अनेक भाषाओं में स्वतंत्र रूप से पाया गया है, लेकिन भाषाओं के बीच तुलना हमेशा गुणात्मक होती है। शोधकर्ता तुर्की या जर्मन में व्यक्तित्व-सूचक विशेषणों का एक सर्वेक्षण कराते हैं, उसका कारक विश्लेषण करते हैं, और फिर कुछ-कुछ देखकर यह तय करते हैं कि कारक एक जैसे हैं या नहीं। इस डेटा का उपयोग यह कहने के लिए नहीं किया जा सकता कि “जर्मन में बहिर्मुखता, अंग्रेज़ी की तुलना में, कर्तव्यनिष्ठा से 15 डिग्री दूर खिसकी हुई है।” इतनी सटीकता के लिए दोनों भाषाओं में कोई साझा आधार होना आवश्यक होगा।
यदि आप कई भाषाओं में प्रश्न कराते हैं, तो आप उन्हें 1) ऐसे द्विभाषी समूह को खोजकर, जो दोनों भाषाओं में उत्तर दे सके, या 2) यह मानकर कि शब्दों के अनुवाद 1:1 हैं (जैसे, स्पेनी भाषा में fun और divertido पूरी तरह समतुल्य हैं), परस्पर संबंधित कर सकते हैं। पहले मामले में चयन का प्रबल प्रभाव होता है। क्या द्विभाषी लोग बेहतर शिक्षित होने की ओर प्रवृत्त होते हैं? दूसरा मामला बस सत्य नहीं है। वास्तव में, भाषाओं का एक साथ कारक विश्लेषण करने का कारण यह समझना है कि उनके बीच व्यक्तित्व की संरचना किस प्रकार अलग हो सकती है। शब्दों को समान मान लेना इस उद्देश्य को ही विफल कर देता है।
मेरे शोध ने दिखाया कि आप अंग्रेज़ी में भाषा मॉडलों से व्यक्तित्व की संरचना निकाल सकते हैं। एक स्वाभाविक प्रश्न यह है कि जब आप अन्य भाषाएँ जोड़ते हैं तो इसमें क्या बदलाव आता है। दर्जनों भाषाओं पर प्रशिक्षित मॉडलों के साथ इसका अन्वेषण करना अपेक्षाकृत आसान हो जाता है। आप कितनी भी भाषाओं को एक ही आधार पर मानचित्रित कर सकते हैं।
बिग टू, एक बार फिर #
मैंने व्यक्तित्व-सूचक विशेषणों के बीच समानता निर्धारित करने के लिए XLM-RoBERTa का उपयोग किया। विचित्र रूप से, यह मॉडल म्यांमार में हुए जनसंहार का परिणाम है। Meta की स्थिति कम ही ईर्ष्या योग्य है: उसे ऐसे स्थानों से सामग्री हटानी होती है जिनके बारे में उसकी समझ बहुत कम होती है। तकनीकी रूप से, इसे स्थानांतरण-अधिगम समस्या कहा जाता है। वे अंग्रेज़ी (या किसी अन्य पर्याप्त स्रोतों वाली भाषा) में घृणा-भाषण वर्गीकारक को प्रशिक्षित करना चाहते हैं और फिर उसे अन्य भाषाओं पर लागू करना चाहते हैं। भाषा मॉडलिंग के अंधकार युग (2018) में यह बहुत खराब ढंग से काम करता था। बर्मी भाषा में “समलैंगिकों को घेरकर मार डालें” के लिए प्रयुक्त बोलचाल की अभिव्यक्ति उनके वर्गीकारकों को “इंद्रधनुषों की संख्या कम होनी चाहिए” जैसी लगती थी। निस्संदेह, यह उनकी कंटेंट मॉडरेशन प्रणाली से बच निकलती थी। NYT ने इसका परिणाम स्पष्ट किया: A Genocide Incited on Facebook, With Posts From Myanmar’s Military
Meta की प्रतिक्रिया एक ऐसा भाषा मॉडल बनाने की थी, जो किसी भी भाषा (खैर, 100 भाषाओं) को एक ही साझा स्थान में शब्द-वेक्टरों पर बेहतर ढंग से मानचित्रित कर सके। इस प्रकार अंग्रेज़ी में प्रशिक्षित घृणा-भाषण वर्गीकारक अन्य भाषाओं तक बेहतर ढंग से विस्तारित हो सकता है। (इसे सूक्ष्म-समायोजित करने के लिए कम बर्मी भाषा की आवश्यकता होती है।) इस मॉडल का उपयोग करके मैंने चार भाषाओं—अंग्रेज़ी, स्पेनी, फ़्रांसीसी और तुर्की—में व्यक्तित्व-सूचक शब्दों का एम्बेडिंग किया। नीचे पहले दो कारक दिए गए हैं:

ये विभिन्न भाषाओं को अलग करने का काम करते हैं। पहला कारक तुर्की को भारोपीय भाषाओं से अलग करता है। दूसरे कारक पर रोमांस भाषाएँ एक-दूसरे के निकट हैं (हालाँकि वे तुर्की के भी काफ़ी निकट हैं)।
यह समझ में आता है। मॉडल को किसी वाक्य के अगले शब्द का अनुमान लगाने के लिए प्रशिक्षित किया जाता है, इसलिए इसमें स्वाभाविक रूप से भाषा-विशिष्ट जानकारी शामिल होगी। यदि कोई स्पेनी भाषा में बात कर रहा है, तो वह प्रायः तुर्की में बोलने नहीं लगता। आशा यह है कि वेक्टर-स्थान में ऐसी दिशाएँ भी होंगी जो व्यक्तित्व-संबंधी जानकारी के अनुरूप हों।
यदि भाषाएँ पर्याप्त रूप से स्वतंत्र हैं, तो चार भाषाओं को अपने-अपने, परस्पर अतिव्यापनरहित समूहों में अलग करने के लिए कम-से-कम 3 आयामों की आवश्यकता होती है। आइए अगले प्रधान घटकों पर नज़र डालें।

कारक 4 पहला ऐसा कारक है जिसे भाषाओं को अलग करने के लिए नहीं सीखा गया था, और यही व्यक्तित्व का सामान्य कारक है! अंग्रेज़ी में: दबंग, निर्दयी, बाध्यताग्रस्त और स्वार्थी बनाम उदार, सौम्य और विचारशील। मैंने तर्क दिया है कि इस कारक को स्वर्णिम नियम के अनुसार जीने की प्रवृत्ति के रूप में सबसे अच्छी तरह समझा जा सकता है। चेतना का ईव सिद्धांत वास्तव में इस बात पर विचार करने का परिणाम था कि हमारे विकासवादी इतिहास में यह किस चीज़ का चयन करेगा। कारक 5 भी व्यक्तित्व से संबंधित है; उन्हें एक साथ आलेखित करने पर:

हमें बिग टू मिलते हैं! कारक पाँच (या व्यक्तित्व कारकों में से दूसरा) गतिशीलता है: साहसिक, कल्पनाशील और उत्साही बनाम सावधान, संकोची और कायर। यह अद्भुत है कि यह इतनी नियमितता से उभरता है। बिग टू के शोध-पत्र पर 2,500 उद्धरण हैं, फिर भी शोधकर्ताओं को यह एहसास नहीं है कि वे सामान्य व्यक्तित्व के पहले दो अपरिभ्रमित कारक मात्र हैं। यह आम धारणा कि वे किसी प्रकार बिग फ़ाइव के साथ पदानुक्रमिक संबंध में विद्यमान हैं, शोधकर्ताओं द्वारा बिग फ़ाइव की सूचियाँ बनाने के कुछ ही समय बाद सीधे भाषा से निपटना छोड़ देने से उत्पन्न हुई। तब से, मूलभूत या सामान्य व्यक्तित्व को समझने का हर प्रयास बिग फ़ाइव के संदर्भ में ही करना पड़ता है। लेकिन शब्द पहले आए थे, और अब भाषा मॉडल भाषा का उस मूलभूत स्तर पर विश्लेषण करना आसान बना देते हैं।
हमें और गहराई में जाना होगा #
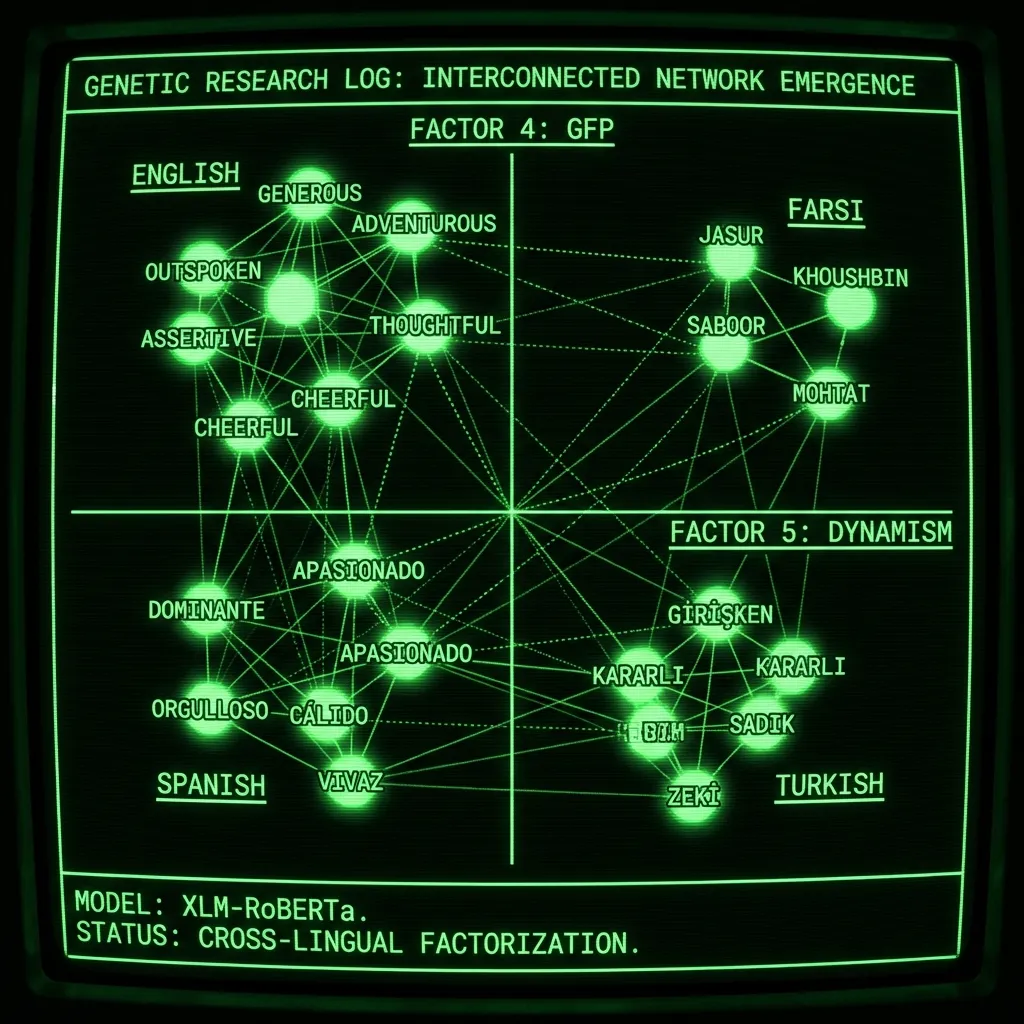
रूसी और फ़ारसी जोड़ने पर वही कारक मिलते हैं:

मेरे आलसी-से इंजीनियर मानकों के अनुसार यह काफ़ी श्रमसाध्य है, क्योंकि इसमें प्रत्येक भाषा के लिए एक अच्छा प्रॉम्प्ट ढूँढ़ना पड़ता है। इसे सही ढंग से करने के लिए मैंने Google Translate और मूल-भाषियों के साथ काम किया, और आप देख सकते हैं कि कारक 4 पर फ़ारसी का वितरण अब भी कुछ अलग है। मेरा अनुमान है कि साझा न होने वाले किसी भी कारक की उपेक्षा करने की मेरी विधि इतनी अधिक भाषाओं के लिए कुछ ज़्यादा ही अस्थिर है। कारक 4 का उपयोग संभवतः GFP के रूप में और फ़ारसी को (थोड़ा-सा) अलग करने के लिए भी किया जाता है। ऐसा कुछ भी नहीं है जो इन कारकों को शुद्ध बनाए रखे; हम वास्तव में भाग्यशाली हैं कि वितरण जितना सुव्यवस्थित है, उतना है। कुछ पूर्वप्रसंस्करण (जैसे प्रत्येक भाषा-समूह का माध्य शून्य करना) इसे हल कर सकता है।
मेरी जानकारी के अनुसार, यह पहली बार है जब अनेक भाषाओं का एक साथ कारक विश्लेषण किया गया है। केवल अंग्रेज़ी और स्पेनी के परिणामों के साथ भी यह प्रकाशन योग्य होता, और यहाँ मैंने छह भाषाओं तक काम किया है, जिनमें दो गैर-भारोपीय भाषाएँ भी शामिल हैं। यह बिग टू की प्रकृति पर भी प्रकाश डालता है—जो मनोमिति की सबसे लोकप्रिय और सबसे गलत समझी गई संरचनाओं में से एक है।
कमियाँ #
मैंने यह शोध लगभग सबसे मूर्खतापूर्ण ढंग से किया। मुझे ESL गाइड में व्यक्तित्व से जुड़े 100 शब्द मिले और फिर मैंने Google Translate का उपयोग करके उनका अन्य भाषाओं में अनुवाद कर दिया। जहाँ दोहराव थे, मैंने उन्हें हटा दिया। यह जितना सुनने में बुरा लगता है, उतना है नहीं। अंग्रेज़ी में पहले दो कारक लगभग अपरिवर्तित रहते हैं, चाहे आप 100 शब्दों का उपयोग करें या 500 का। लेकिन, यदि यह वास्तविक शोध-पत्र होता, तो स्पष्ट रूप से आप प्रत्येक शब्दावली में स्वतंत्र रूप से शब्दों का एक समूह विकसित करना चाहते। इसकी कई अन्य कमियाँ भी हैं:
पर्याप्त भाषाएँ नहीं हैं! यदि मैं इसे प्रकाशित करता, तो मैं ऐसी दर्जन भर और भाषाएँ जोड़ना चाहता, जिनका व्यक्तित्व-विज्ञान में आम तौर पर अध्ययन नहीं किया जाता। वास्तव में, इसी कारण मैं इसे प्रकाशित करने का समय कभी नहीं निकाल पाया। यह बहुत अधिक काम है और इसके लिए कई एशियाई भाषाओं के मूल वक्ताओं की आवश्यकता होगी।
प्रशिक्षण-आँकड़ों से विकृत बहुभाषी मॉडल। भाषा-मॉडलों को किसी वाक्य के अगले शब्द का अनुमान लगाने के लिए प्रशिक्षित किया जाता है। यदि आप उन्हें अनेक भाषाओं के साथ प्रशिक्षित करते हैं, तो मॉडल कुछ ज्ञान को एक भाषा से दूसरी भाषा में स्थानांतरित करने का प्रयास करेगा। हालाँकि, छोटी भाषाओं के मामले में ऐसा लग सकता है कि उनके अर्थों को बेहतर-स्रोतित भाषाओं (अंग्रेज़ी, चीनी, रूसी आदि) के भीतर मौजूद सादृश्यों के अनुरूप बलपूर्वक ढाला जा रहा है।
प्रश्न शोधकर्ता के विवेकाधिकार का विषय हैं। शब्दों को एम्बेड करने के लिए मैं जिस विधि का उपयोग करता हूँ, वह है: “मेरे व्यक्तित्व का वर्णन
पुराना भाषा मॉडल। मैंने यह काम 2 वर्ष से अधिक पहले किया था, GPT-4 के सामने आने से बहुत पहले। वे सरल समय थे।
निष्कर्ष #
यदि मैं अभी भी अकादमिक जगत में होता, तो यही मेरा शोध-कार्यक्रम होता। अधिक-से-अधिक भाषाएँ जोड़ना और उन सभी तरीकों को समझने का प्रयास करना, जिनसे यह विधि पक्षपाती हो सकती है। अंततः, यह बिग फ़ाइव से बेहतर व्यक्तित्व का एक सार्वभौमिक मॉडल उत्पन्न कर सकता है। इससे हमें यह बेहतर समझने में सहायता मिलेगी कि हम कौन हैं और शायद यह भी कि हम कहाँ से आए। क्योंकि अब हमारी प्रजाति को परिभाषित करने वाली चीज़ भाषा है, और सुदूर अतीत में हमारे मानस को गढ़ने वाली चीज़ भी भाषा ही थी। हम आदतन सामाजिक हैं, क्योंकि हज़ारों वर्ष पहले अपनी प्रतिष्ठा सँभालने में असफल होना मृत्यु के समान था। व्यक्तित्व-मॉडल भाषा के मानचित्र हैं; वे हमारे मन के विकास में सदिश हैं।

अन्य लेख पढ़ें