La personalidad en todo el mundo
The Big Two in English, Spanish, French, Russian, Turkish, and Persian
Publicado originalmente por Vectors of Mind.
Bien, tomémonos un pequeño respiro de todo lo relacionado con la sapiencia. En realidad, tenía un montón de psicometría en espera antes de que me atrajera la llamada del clarín de la conciencia. Es muy difícil apartar la mirada.

Comencé este blog para explorar la hipótesis léxica desde la perspectiva del aprendizaje automático. Los modelos de personalidad definen los rasgos de los que más se habla en una lengua, y podemos medir eso mucho mejor en la era de GPT. Los modelos de personalidad derivados ya sea de vectores de palabras o de encuestas tradicionales convergen en los mismos pocos rasgos, especialmente en los Dos Grandes: la autorregulación social y el dinamismo. Para refrescar la memoria al respecto, consulta Los Cinco Grandes son vectores de palabras y El factor primario de la personalidad.
Los Cinco Grandes se han encontrado de manera independiente en muchas lenguas, pero la comparación entre lenguas siempre es cualitativa. Los investigadores aplican una encuesta de adjetivos de personalidad en turco o alemán, la factorizan y más o menos examinan los factores a ojo para ver si son los mismos. Estos datos no pueden utilizarse para afirmar que «la extraversión está desplazada 15 grados respecto de la responsabilidad en alemán, en comparación con el inglés». Para ser tan precisos, ambas lenguas tendrían que compartir alguna base.
Si aplicas preguntas en varias lenguas, puedes relacionarlas de dos maneras: 1) encontrando una cohorte bilingüe que pueda responder en ambas lenguas, o 2) suponiendo que las traducciones de las palabras son equivalentes 1:1 (por ejemplo, que fun es perfectamente equivalente a divertido en español). En el primer caso, existe un fuerte efecto de selección. ¿Qué ocurre si las personas bilingües tienden a tener una mejor educación? El segundo supuesto simplemente no es cierto. De hecho, la razón para factorizar conjuntamente las lenguas es entender cómo puede divergir entre ellas la estructura de la personalidad. Suponer que las palabras son iguales frustra el propósito.
Mi investigación mostró que se puede extraer la estructura de la personalidad de los modelos de lenguaje en inglés. Una pregunta natural es cómo cambia eso cuando se añaden otras lenguas. Con modelos entrenados en docenas de lenguas, explorar esto se vuelve bastante sencillo. Se puede mapear cualquier número de lenguas a la misma base.
Los Dos Grandes, una vez más #
Utilicé XLM-RoBERTa para asignar similitud entre adjetivos de personalidad. Extrañamente, este modelo es resultado del genocidio en Myanmar. Meta ocupa la poco envidiable posición de tener que eliminar contenido en lugares sobre los que tiene muy poco conocimiento. Técnicamente, esto se denomina un problema de aprendizaje por transferencia. Querrían entrenar un clasificador de discurso de odio en inglés (o en otra lengua con abundantes recursos) y después hacer que se aplique a otras lenguas. En la edad oscura del modelado del lenguaje (2018), esto funcionaba muy mal. El discurso coloquial en birmano para «reunamos a los gays y matémoslos» se veía ante sus clasificadores como «debería haber menos arcoíris». Esto, por supuesto, pasó inadvertido a su moderación de contenido. El NYT explicó la consecuencia: A Genocide Incited on Facebook, With Posts From Myanmar’s Military
La respuesta de Meta fue construir un modelo de lenguaje que pudiera mapear mejor cualquier lengua —bueno, 100 lenguas— a vectores de palabras en el mismo espacio compartido. De ese modo, un clasificador de discurso de odio entrenado en inglés puede extenderse mejor a otras lenguas. (Se necesita menos birmano para el ajuste fino.) Utilizando este modelo, generé embeddings de palabras de personalidad en cuatro lenguas: inglés, español, francés y turco. A continuación se muestran los dos primeros factores:

Estos sirven para separar las distintas lenguas. El primer factor distingue el turco de las lenguas indoeuropeas. En el segundo factor, las lenguas romances son adyacentes (aunque también cercanas al turco).
Esto tiene sentido. El modelo está entrenado para predecir la siguiente palabra de una oración, por lo que naturalmente incluirá información específica de cada lengua. Si alguien habla en español, no suele cambiar al turco. La esperanza es que también haya direcciones en el espacio vectorial que correspondan a información sobre la personalidad.
Si las lenguas son bastante independientes, se necesitan al menos 3 dimensiones para separar 4 lenguas en grupos propios que no se superpongan. Examinemos los siguientes componentes principales.

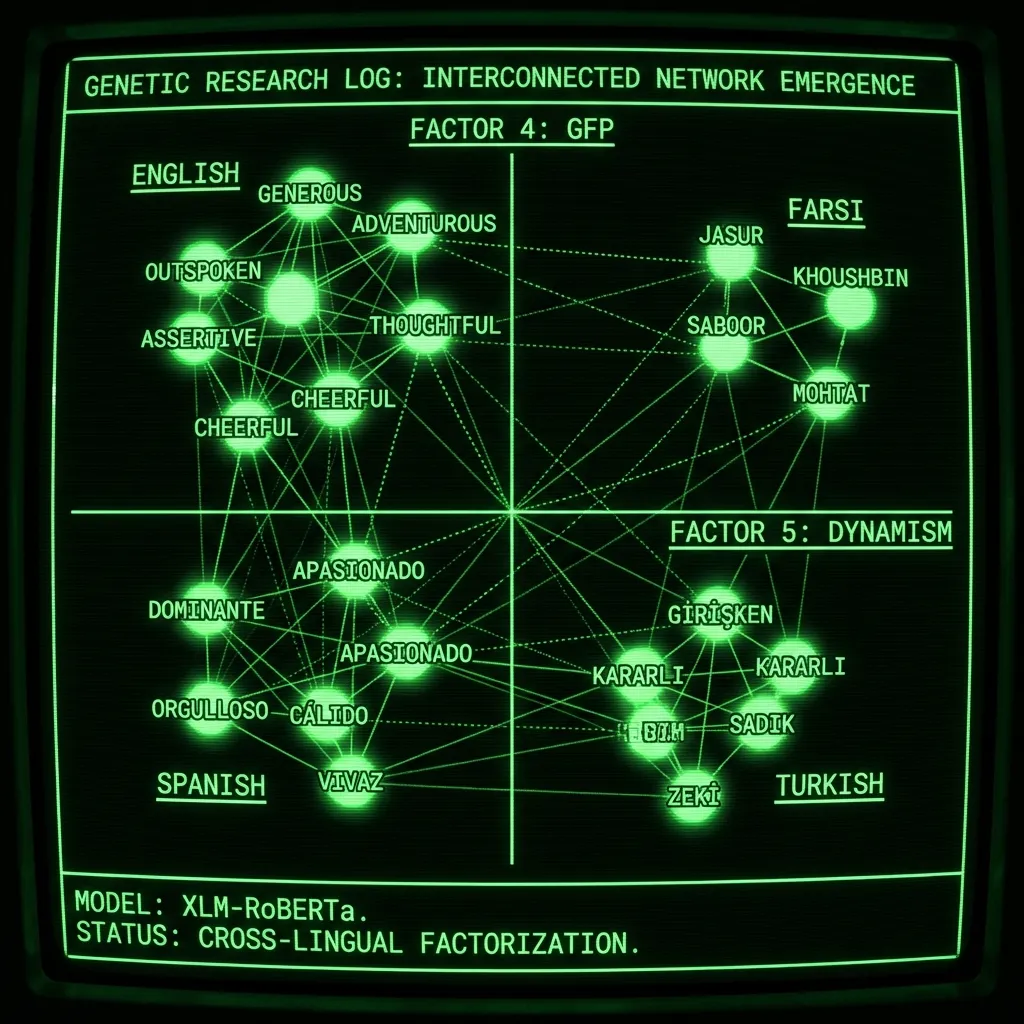
El factor 4 es el primer factor que no se aprendió para separar las lenguas, ¡y es el Factor General de la Personalidad! En inglés: dominante, despiadado, compulsivo y egoísta frente a generoso, amable y considerado. He sostenido que este factor se entiende mejor como la tendencia a vivir de acuerdo con la Regla de Oro. La Teoría de Eva de la Conciencia fue, en realidad, resultado de preguntarme qué seleccionaría esto en nuestra historia evolutiva. El factor 5 también se relaciona con la personalidad; tracémoslos juntos:

¡Obtenemos los Dos Grandes! El factor cinco (o el segundo de los factores de personalidad) es el Dinamismo: aventurero, imaginativo y entusiasta frente a cauteloso, reservado y cobarde. Es asombroso que esto emerja con tanta regularidad. Hay 2.500 citas del artículo sobre los Dos Grandes, y aun así los investigadores no se dan cuenta de que simplemente son los dos primeros factores no rotados de la personalidad general. La creencia común de que de algún modo existen en una relación jerárquica con los Cinco Grandes proviene de que los investigadores abandonaron el tratamiento directo del lenguaje poco después de elaborar los inventarios de los Cinco Grandes. Desde entonces, cualquier intento por comprender la personalidad básica o general debe hacerse con referencia a los Cinco Grandes. Pero las palabras vinieron primero, y ahora los modelos de lenguaje facilitan analizar el lenguaje en ese nivel fundamental.
Tenemos que profundizar #
Añadir el ruso y el persa produce los mismos factores:

Según mis estándares de ingeniero bastante holgazán, esto requiere mucho trabajo, porque es necesario encontrar un buen prompt para cada lengua. Trabajé con Google Translate y con hablantes nativos para lograrlo, y se puede ver que la distribución del persa sigue estando desviada en el factor 4. Supongo que mi método de ignorar cualquier factor que no sea compartido resulta demasiado rudimentario para tantas lenguas. Probablemente el factor 4 se utilice como el GFP y también para separar el persa (aunque solo un poco). Nada mantiene puros estos factores; tenemos mucha suerte de que la distribución se comporte tan bien como lo hace. Hacer algún preprocesamiento (como centrar en cero cada clúster lingüístico) podría resolverlo.
Hasta donde sé, esta es la primera vez que se han factorizado conjuntamente varias lenguas. Esto sería publicable con resultados obtenidos únicamente en inglés y español, y aquí llegué hasta seis, incluidas dos lenguas no indoeuropeas. También arroja luz sobre la naturaleza de los Dos Grandes, uno de los constructos más populares —y malinterpretados— de la psicometría.
Deficiencias #
Hice esta investigación de la manera más tonta posible. Encontré 100 palabras relacionadas con la personalidad en una guía de inglés como segunda lengua y luego las traduje a otras lenguas mediante Google Translate. Cuando había duplicados, los eliminé. Esto no es tan malo como parece. Los dos primeros factores prácticamente no cambian en inglés, ya sea que se utilicen 100 o 500 palabras. Pero, si esto fuera un artículo académico real, evidentemente querríamos desarrollar de manera independiente un conjunto de palabras en cada vocabulario. Hay varias otras deficiencias:
¡No hay suficientes lenguas! Si publicara esto, me gustaría añadir una docena más de lenguas que no suelen estudiarse en la ciencia de la personalidad. De hecho, esta es la razón por la que nunca llegué a publicarlo. Es mucho trabajo y requeriría hablantes nativos de varias lenguas asiáticas.
Modelos multilingües distorsionados por los datos de entrenamiento. Los modelos de lenguaje se entrenan para predecir la siguiente palabra de una oración. Si se entrenan con varias lenguas, el modelo intentará transferir parte de ese conocimiento. Sin embargo, en el caso de las lenguas más pequeñas, esto podría parecerse más a que sus significados son forzados a ajustarse a analogías presentes en las lenguas con más recursos (inglés, chino, ruso, etc.).
Las consultas constituyen grados de libertad del investigador. El método que utilizo para generar embeddings de palabras es “My personality can be described as
Modelo de lenguaje obsoleto. Realicé este trabajo hace más de 2 años, mucho antes de que apareciera GPT-4. Eran tiempos más sencillos.
Conclusión #
Si todavía estuviera en el ámbito académico, esta sería mi agenda de investigación. Añadir tantas lenguas como fuera posible e intentar comprender todas las formas en que el método puede estar sesgado. Al final, podría producir un modelo universal de la personalidad superior al de los Cinco Grandes. Nos ayudaría a comprender mejor quiénes somos y quizá incluso de dónde venimos. Porque ahora es el lenguaje lo que define a nuestra especie, y fue el lenguaje lo que forjó nuestra psique en un pasado remoto. Somos sociales por hábito porque, hace miles de años, no gestionar la propia reputación equivalía a morir. Los modelos de la personalidad son mapas del lenguaje; son vectores en la evolución de nuestra mente.

Leer otros artículos